Clasificar el riesgo de un cambio: una matriz práctica para decidir qué revisa una persona y qué una máquina
En el artículo sobre deuda de verificación una de las palancas de mitigación era asignar por riesgo: revisión humana completa donde fallar cuesta caro, y verificación automática en el resto. La tabla resumía cuatro niveles, pero dejaba la pregunta práctica sin responder: ¿cómo se decide, cambio por cambio, en qué nivel cae?
Este artículo propone una forma de hacerlo: una lista de preguntas en orden, los controles que corresponden a cada nivel, casos frontera para calibrar el criterio y una regla para equivocarse en la dirección segura. Al final la aplicamos a nuestros propios 141 PRs, y el resultado no nos deja bien parados.
Por qué clasificar
La atención humana es el recurso escaso. Si se reparte igual entre todos los cambios, los importantes reciben lo mismo que una corrección de texto. El modelo del primer artículo lo dice con la pérdida esperada:
Una hora de revisión rinde más donde el producto entre la probabilidad de fallo y su costo es mayor. Clasificar el riesgo es estimar ese producto antes de decidir cuánta atención dar.
La matriz: preguntas en orden
Se responden de arriba abajo. El primer «sí» decide el nivel.
| # | Pregunta | Si la respuesta es sí |
|---|---|---|
| 1 | ¿Un fallo puede dañar la seguridad o la salud de personas, violar una regulación o afectar el núcleo de cálculo de un sistema crítico? | Crítico |
| 2 | ¿Toca dinero (cobros, precios, redondeos, saldos)? | Alto |
| 3 | ¿Toca quién puede ver o cambiar qué (autenticación, permisos, datos personales)? | Alto |
| 4 | ¿Cambia datos persistentes (migraciones, borrados, esquemas)? | Alto |
| 5 | ¿Cambia un contrato público (una API o un evento que consumen otros)? | Alto |
| 6 | ¿Toca seguridad o infraestructura (secretos, red, permisos de nube, CI/CD, los controles del agente)? | Alto |
| 7 | ¿Procesa entradas externas o salida de un modelo de IA que llega a clientes? | Alto |
| 8 | ¿Cambia lógica de negocio? | Medio |
| 9 | ¿Es solo texto, estilos, documentación, pruebas nuevas o un refactor cubierto por pruebas? | Bajo |
Modificadores que suben un nivel:
- El cambio es irreversible o su reversión no está ensayada (un correo enviado, un cobro hecho, un borrado sin copia).
- El radio de impacto es todo el sistema o todos los usuarios, sin despliegue gradual.
- Nadie del equipo conoce ese código: el riesgo está en la falta de contexto.
- El código lo generó la IA sin pruebas escritas antes.
Una regla que no se negocia: el nivel se puede subir, nunca bajar. Quien revisa puede subirlo; nadie lo baja para ir más rápido.
Qué revisa quién en cada nivel
| Bajo | Medio | Alto | Crítico | |
|---|---|---|---|---|
| Verificación automática (pruebas, tipos, análisis estático, secretos) | Sí | Sí | Sí | Sí |
| Revisión de un agente con un modelo distinto al que generó | Opcional | Sí | Sí | Sí |
| Revisión humana | Por muestreo | Pruebas y criterios de aceptación | Línea por línea | Línea por línea, dos personas independientes |
| Aprobaciones | 1 | 1 | 2, una con experiencia | 2 independientes + responsable del área |
| Evidencia | Verificación en verde | + una prueba por criterio de aceptación | + mutación sobre lo cambiado, modelo de amenazas, reversión ensayada | + verificación formal o por propiedades del núcleo |
| Despliegue | Normal | Normal | Gradual, con reversión automática | Gradual, con ventana y plan de contingencia |
| Auditoría por muestreo (revisión profunda posterior) | 5% de los cambios | 20% | No aplica: ya se revisó todo | No aplica |
Los porcentajes de muestreo son una propuesta. Sirven para estimar cuánto se escapa en los niveles bajos sin revisarlo todo; si el muestreo encuentra muchos defectos, el nivel estaba mal calibrado.
Casos frontera
La matriz se aprende con ejemplos. Estos diez sirven para calibrar:
| Cambio | Nivel | Por qué |
|---|---|---|
| Corregir una errata en la página de ayuda | Bajo | Solo texto |
| Cambiar el texto de los términos y condiciones | Medio | Es texto, pero tiene efecto legal: lo revisa una persona |
| Cambiar cómo se redondea un precio que solo se muestra | Alto | Toca dinero, aunque no cobre: el cliente ve un precio y espera pagarlo |
| Agregar una columna opcional a una tabla | Alto | Datos persistentes, aunque la migración sea aditiva |
| Cambiar un tiempo de espera de 30 a 60 segundos | Medio, o alto si está en la infraestructura | Puede alterar costos o cascadas de fallos |
| Agregar una dependencia nueva | Alto | Cadena de suministro: hay que verificar que existe, quién la publica y desde cuándo |
| Ajustar el prompt de un asistente que responde a clientes | Alto | Entrada externa y salida de IA que llega a clientes |
| Refactor de un módulo sin pruebas | Medio, sube a alto si nadie lo conoce | El refactor «sin cambio de comportamiento» no está verificado |
| Cambiar estilos de forma que se oculta el botón de cancelar una suscripción | Alto | Por archivo es estilo; por efecto toca dinero y derechos del cliente |
| Cambiar la regla que calcula una dosis o una calificación oficial | Crítico | Daño a personas o efecto regulado |
El penúltimo es el más importante: se clasifica por el efecto, no por el archivo. Una regla que mire solo rutas lo clasificaría como bajo.
Lo que pasó al aplicarla a nuestros 141 PRs
Aplicamos la guía de riesgo de nuestro propio repositorio a los 141 PRs integrados entre el 17 de septiembre y el 17 de octubre de 2026, los mismos del artículo anterior. La clasificación es heurística: mira las rutas que toca cada PR, con las limitaciones del caso frontera de arriba.
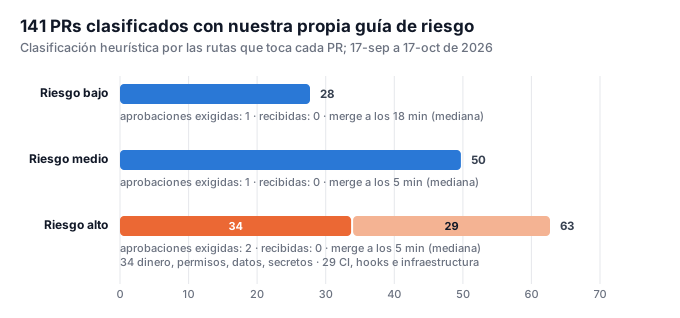
| Nivel | PRs | Aprobaciones que exige la guía | Recibidas | Mediana de abrir a integrar |
|---|---|---|---|---|
| Bajo | 28 | 1 | 0 | 18 min |
| Medio | 50 | 1 | 0 | 5 min |
| Alto | 63 | 2 | 0 | 5 min |
De los 63 de riesgo alto, 29 solo tocan CI, hooks o infraestructura: la construcción de los propios controles. Los otros 34 tocan permisos (23), migraciones (12), secretos (11), dinero (3) o un contrato público (1); un PR puede tocar varias.
Tres lecturas incómodas:
- Casi la mitad de los cambios fue de riesgo alto. No es raro en un mes dedicado a montar pipelines y controles, pero es mucho más de lo que intuíamos.
- La intensidad de revisión no siguió al riesgo. Los PRs de riesgo alto se integraron igual de rápido que los de riesgo medio, y más rápido que los de riesgo bajo. Ninguno tuvo la segunda aprobación que exige la guía.
- La guía existía, pero no se aplicaba con un mecanismo. El control que exige aprobaciones está en modo de aviso por ser un equipo de una persona. Una regla que no falla sola es una buena intención.
Qué está medido y qué no
| Afirmación | Estado |
|---|---|
| 63 de 141 PRs tocaron áreas de riesgo alto según la guía | Medido con una heurística por rutas |
| Ningún PR recibió las aprobaciones que exige su nivel | Medido |
| Los PRs de riesgo alto se revisaron menos que los de riesgo bajo | No medido: el tiempo hasta el merge no mide el tiempo de revisión |
| La matriz propuesta reduce los defectos que llegan a producción | No medido: es una propuesta |
| Los porcentajes de muestreo son los correctos | No medido: hay que calibrarlos con datos |
Riesgos de clasificar
- Clasificar por archivo en vez de por efecto. Es la forma más fácil de automatizar y la más fácil de engañar, como muestra el botón oculto.
- Que la clasificación se vuelva trámite. Si siempre se elige «bajo» para ir rápido, la matriz solo agrega papeleo. Por eso el nivel solo se puede subir y conviene que lo confirme alguien distinto del autor.
- Calibrar una vez y no volver a mirar. El muestreo existe para corregir la matriz con lo que se encuentra.
- Inflar todo a alto. Si todo es alto, nada lo es: se vuelve a revisar todo igual.
Lo que este artículo no afirma
- No afirma que esta matriz sirva igual para cualquier equipo. Los niveles de un sistema de pagos y los de un blog no se parecen; cada equipo ajusta las preguntas a su dominio.
- No afirma que lo de riesgo bajo no se revise. Se revisa por muestreo, que es distinto de no revisar.
- No afirma que nuestros PRs de riesgo alto tuvieran defectos. Afirma que no recibieron los controles que nuestra propia guía exige.
Fuentes
- Guía de revisión por riesgo del repositorio (
11-quality/risk-based-review.md), en la que se basa la matriz. - Historial de PRs del repositorio, consultado el 17 de octubre de 2026, y el script de clasificación usado.
- Dixi-Project: Deuda de verificación, Acotar, especificar y auditar, ¿Las pruebas de la IA atrapan los errores de la IA?, Un mantenedor, un agente y 141 PRs sin revisión humana y La cantera rota (2026).