Un mantenedor, un agente y 141 PRs sin revisión humana: ¿los controles automáticos sustituyen a la revisión o solo la disfrazan?
En el artículo sobre deuda de verificación dejamos un caso abierto: un repositorio de producción con un solo mantenedor, controles automáticos instrumentados y ningún PR revisado por otra persona. La pregunta era incómoda: ¿los controles automáticos sustituyen a la revisión humana, o solo la disfrazan?
Ese repositorio es el nuestro: la plataforma de Dixi-Project (sitio web, cursos, soporte, panel de administración y API). Este artículo cuenta sus primeros treinta días con todos los PRs pasando por un pipeline, con los datos reales: lo que los controles detuvieron, lo que se les escapó y lo que no sabemos medir. Incluye lo que salió mal.
La respuesta corta: no sustituyen la revisión, pero tampoco son un disfraz. Sustituyen la parte procedimental (¿se siguió el proceso?) y no la parte de juicio (¿es correcto este cambio?). El riesgo de disfraz aparece cuando un control en verde se lee como si respondiera la segunda pregunta.
El caso
Del 17 de septiembre al 17 de octubre de 2026:
| Indicador | Valor |
|---|---|
| PRs integrados | 141 |
| PRs con revisión de otra persona | 0 |
| Personas que integran | 1 |
| Commits con coautoría de IA | 236 de 268 (88%) |
| Tiempo mediano entre abrir un PR e integrarlo | 6 minutos |
| PRs integrados en menos de 10 minutos | 82 (58%) |
| Tamaño mediano, en líneas de código | 66 (percentil 90: 395) |
| Ejecuciones de despliegue en las seis pipelines | 210 |
No hay revisión de otra persona porque no hay otra persona: es el modo de mantenedor único, una excepción registrada en una decisión de arquitectura. El control que exige una aprobación distinta del autor está en modo de aviso hasta enero de 2027.
Los controles que sí existen
Cada control es un mecanismo que falla solo, no una buena intención:
- Antes de que el agente actúe: el agente no puede leer secretos, editar pruebas ya aprobadas, firmar commits, marcar la casilla de responsabilidad, integrar PRs ni aprobar despliegues. Lo impiden hooks que revisan cada acción. Todo eso lo hace una persona.
- Antes de dar algo por terminado: el agente no puede declarar una tarea lista con la verificación local en rojo (suites de prueba, validación de documentación, matriz de hooks).
- Después del merge, en el Gate de la pipeline: comprueba que el commit venga de un PR, que las pruebas pasen, que no haya vulnerabilidades nuevas en dependencias, que no haya secretos ni hallazgos nuevos de análisis estático, y el control de responsabilidad humana: casilla de atestación marcada, commits firmados por la persona, tamaño máximo y, si el PR toca el propio Gate, dos horas de espera entre el último cambio y el merge.
- Antes de producción: una aprobación manual que compara la revisión en espera con el último commit de la rama principal.
Un detalle de diseño importa: por limitaciones del servicio de integración continua, el Gate corre después del merge. Un PR que no cumple queda en la rama principal, pero no se despliega.
Lo que los controles detuvieron
De 210 ejecuciones de despliegue, 65 se detuvieron. Detrás hay 31 revisiones distintas, porque un mismo merge dispara varias pipelines.
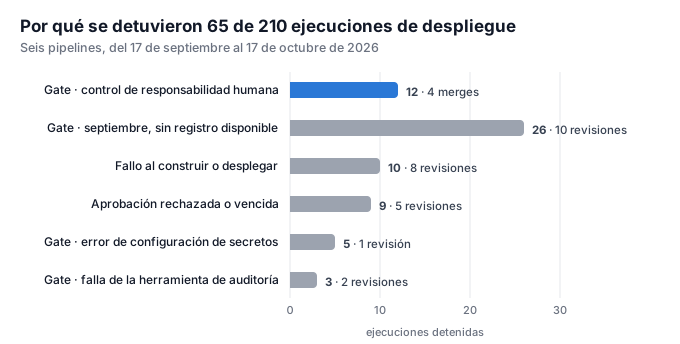
| Causa | Ejecuciones | Revisiones |
|---|---|---|
| Gate: control de responsabilidad humana | 12 | 4 |
| Gate: septiembre, sin registro disponible | 26 | 10 |
| Fallo al construir o desplegar | 10 | 8 |
| Aprobación manual rechazada o vencida | 9 | 5 |
| Gate: error de configuración de secretos | 5 | 1 |
| Gate: falla de la herramienta de auditoría de dependencias | 3 | 2 |
Los cuatro merges que detuvo el control de responsabilidad humana:
- Dos PRs que modificaban el propio Gate se integraron antes de las dos horas de espera. El control los rechazó y no se desplegaron hasta que un PR posterior cumplió.
- Un PR con tres commits sin la firma de la persona.
- Un PR sin la casilla de atestación marcada y sin firmas.
Lo que conviene notar: los cuatro rechazos son de proceso, no de código. El Gate no encontró un defecto en ninguno de esos cambios; encontró que no se había seguido el procedimiento. Las otras causas son fallas de infraestructura o de la propia herramienta. Los registros de septiembre ya no están disponibles, así que no sabemos qué detuvo esas 26 ejecuciones.
Lo que se les escapó
Estos problemas llegaron a producción o se descubrieron por otra vía. Los describimos sin detalles que comprometan la seguridad:
| Fecha | Qué pasó | Cómo se descubrió | Qué cambió después |
|---|---|---|---|
| 16-sep | Las URLs directas de dos de los sitios abrían la portada en lugar de su página; entre ellas, el enlace de recuperación de contraseña que reciben los estudiantes | Al usarlas | Se configuró la regla que faltaba en la red de distribución |
| 17-sep | Se aprobó una ejecución vieja que esperaba en la cola, y se desplegó código anterior dos veces | Al revisar lo desplegado | Un script que compara la revisión en espera con el último commit antes de aprobar |
| 21-sep | Una pipeline terminó en verde, pero no publicaba el componente que se creía publicado | Al notar que el cambio no estaba | Documentado; ese componente se publica con un procedimiento aparte |
| 7-oct | Se perdieron archivos de un almacenamiento, sin copia ni registro de quién los borró | Al no encontrarlos | Versionado con recuperación de 90 días |
| 10-oct | La subida de archivos desde el panel fallaba por una configuración faltante | Al intentar subir | Se restauró la configuración |
| Octubre | Las fechas del servidor se mostraban 6 horas adelantadas | Al ver las fechas | Una función única para leer fechas del servidor en las tres aplicaciones |
| 17-oct | El ejecutor de un experimento del blog no registraba ciertos fallos y reportaba de más | Un resultado que no cuadraba | Se corrigió y se repitió el análisis (lo contamos aquí) |
Dos patrones:
- Casi ninguno era un defecto visible en el diff del PR. Eran configuración de infraestructura, estado operativo o pasos manuales. Una revisión línea por línea del código probablemente tampoco los habría atrapado. La excepción son las fechas, que sí estaban en el código.
- Varios controles nacieron de un incidente. El script de aprobación existe porque el 17 de septiembre se aprobó lo que no era. Es el patrón de mejora sano, pero también dice que el sistema de controles va un paso detrás de los problemas.
Qué está medido y qué no
| Afirmación | Estado |
|---|---|
| Ningún PR tuvo revisión de otra persona | Medido |
| Los controles automáticos detuvieron despliegues reales | Medido: 4 merges por responsabilidad humana, más fallas de infraestructura |
| Los controles encontraron defectos de código | No se observó en los rechazos con registro disponible |
| Los problemas que se escaparon habrían sido atrapados por una revisión humana | No se puede saber; la mayoría no estaba en el código |
| El mantenedor revisa cada PR | No medido: la casilla dice que sí, y en 6 minutos de mediana cabe poco |
| Los hooks evitaron acciones del agente | Sí ocurrió, pero no se registra cuántas veces |
Explicaciones rivales
- La revisión ocurre antes del PR. En este flujo, la persona trabaja con el agente en la misma sesión: lee, pide cambios y prueba antes de abrir el PR. Los 6 minutos medianos miden el trámite, no la revisión. Es plausible, y es justo lo que la casilla de atestación pretende capturar, pero no deja evidencia verificable por terceros.
- Selección. Una parte de los PRs es contenido del blog, documentación o ajustes menores. El riesgo promedio de un PR de este repositorio es menor que el de un sistema de pagos.
- Desplazamiento. La verificación no desapareció: pasó al Gate, a las pruebas y a la aprobación de producción. Eso es cierto para el proceso, y no para el juicio sobre si un cambio es correcto.
Entonces, ¿sustituyen o disfrazan?
Sustituyen la parte procedimental. Garantizan que nada se despliega sin firma, sin atestación, con pruebas en rojo o con secretos expuestos, y que nadie se salta la espera cuando toca el propio sistema de control. Esa parte funciona, y los cuatro rechazos lo demuestran.
No sustituyen el juicio. Ningún control pregunta si el cambio es el correcto, si la configuración de producción coincide con lo que se cree o si lo desplegado es lo que se quería desplegar. Lo que se escapó vivía justo en ese espacio.
Pueden disfrazar cuando se lee un Gate en verde como si respondiera esas preguntas. Nuestro propio ejecutor del experimento lo mostró en pequeño: reportó en verde lo que no había revisado.
Qué cambiaríamos
- Verificación después del despliegue. Varias fallas se habrían detectado con una prueba contra lo desplegado: ¿la URL directa abre su página?, ¿la versión publicada es la del commit?
- Registrar lo que detienen los hooks. Hoy se sabe que funcionan, pero no cuántas veces ni qué evitaron.
- Auditoría por muestreo. Elegir al azar algunos PRs al mes y revisarlos en frío, con tiempo, para estimar cuánto se escapa en lugar de suponerlo.
- Separar el riesgo. Para los cambios de alto riesgo (dinero, datos personales, autenticación), una segunda revisión aunque sea de alguien externo, o al menos de un modelo distinto, como sugiere el experimento de causa común.
- Conservar los registros. Perdimos los de septiembre; sin ellos, el primer mes no se puede auditar.
Lo que este artículo no afirma
- No afirma que un mantenedor único sea una buena práctica. Es una excepción registrada, con fecha para dejar de serlo.
- No afirma que los controles automáticos basten. Afirma que cubren el procedimiento y que el juicio sigue sin cubrir.
- No afirma que la revisión humana habría evitado los incidentes. La mayoría no estaba en el código del PR.
- No generaliza. Es un solo repositorio, de un solo equipo, durante un mes.
Fuentes
- Historial de PRs y commits del repositorio, consultado el 17 de octubre de 2026.
- Historial de ejecuciones de las seis pipelines de despliegue y registros de su etapa Gate, consultados el 17 de octubre de 2026. Los de septiembre ya no estaban disponibles.
- Bitácora de incidentes y decisiones del propio proyecto.
- Dixi-Project: Deuda de verificación, Acotar, especificar y auditar, Enseñar ingeniería de software cuando la IA programa y ¿Las pruebas de la IA atrapan los errores de la IA? (2026).