¿Las pruebas de la IA atrapan los errores de la IA? Un experimento de causa común con pruebas de mutación
En el artículo sobre deuda de verificación planteamos una hipótesis que, si fuera cierta, tendría consecuencias incómodas. La llamamos H3, causa común: las pruebas que escribe una IA no detectan los errores del código de esa misma IA, porque los dos comparten los mismos puntos ciegos. Si eso pasa, generar más pruebas con la misma IA no baja el riesgo. Hay un piso que no se rompe.
Dijimos también que era el resultado más barato de producir. Así que lo produjimos: un experimento pequeño, con el diseño y el criterio de éxito escritos antes de generar una sola línea de código.
El resultado, por adelantado: en este entorno, el experimento no apoyó la hipótesis. Las cuatro suites de pruebas detectaron entre 97.9% y 99.7% de los errores sembrados, y la comparación que fijamos de antemano no alcanzó el umbral. Apareció, eso sí, un patrón pequeño que vale la pena contar: las dos suites escritas por el mismo modelo que escribió el código dejaron pasar exactamente los mismos errores en un módulo, vieran o no el código.
La pregunta
Si quien escribe el código y quien escribe las pruebas comparten un sesgo, un error puede pasar los dos filtros a la vez. Knight y Leveson lo midieron en 1986 con programas escritos por personas de forma independiente: fallaban en los mismos sitios. Con IA, la sospecha es mayor, porque el mismo modelo puede escribir el código y sus pruebas en la misma conversación.
Hay dos fuentes posibles de ese sesgo compartido, y conviene separarlas:
- Compartir el modelo: el mismo modelo comete los mismos errores, o las mismas omisiones, al programar y al probar.
- Ver el código: quien prueba mirando la implementación tiende a confirmar lo que el código hace, en lugar de lo que debería hacer. Si el código tiene un error, la prueba lo «congela» como comportamiento esperado.
El diseño
Doce módulos pequeños de Python, cada uno con una especificación escrita y casos frontera explícitos: validación de Luhn, comparación de versiones semánticas, fusión de intervalos, redondeo bancario, ajuste de líneas, números romanos, cubeta de fichas, campos CSV con comillas, duraciones ISO 8601, solapamiento de fechas, política de contraseñas y normalización de teléfonos de México.
Un subagente con el modelo Opus, con contexto limpio, escribió las doce implementaciones leyendo solo las especificaciones. Después, cuatro subagentes distintos escribieron una suite de pruebas cada uno, con instrucciones idénticas salvo por lo que podían leer:
| Ve el código y la especificación | Solo ve la especificación | |
|---|---|---|
| Mismo modelo que escribió el código (Opus) | A | B |
| Otro modelo (Sonnet) | C | D |
Como oráculo escribimos a mano una implementación de referencia de cada módulo, antes de generar nada, y la comprobamos contra los 69 ejemplos de las especificaciones. Ningún subagente pudo verla.
Métricas, en orden de importancia:
- Defectos reales atrapados. Comparamos el código generado contra la referencia con miles de entradas aleatorias. Cada discrepancia es un defecto real, y medimos qué fracción detecta cada suite.
- Puntaje de mutación. Sembramos errores pequeños en el código generado (cambiar un
<por un<=, unandpor unor, una constante por otra) y medimos cuántos detecta cada suite. - Pruebas que afirman algo falso: las que fallan contra la referencia.
El puntaje de mutación de una suite es la fracción de mutantes distinguibles que detecta:
Para comparar dos suites módulo por módulo usamos la prueba de signo: si una detecta menos en g de los n módulos sin empate, la probabilidad de un resultado igual o más extremo por puro azar es
Criterio fijado de antemano. La hipótesis se apoyaría si la suite A detectaba menos que la D en al menos 10 de los 12 módulos, o con una diferencia de 15 puntos o más. Se refutaría si la diferencia aparecía en la misma dirección en menos de 9 módulos. Y si el código generado salía sin defectos reales, la primera métrica no tendría con qué medir: lo reportaríamos así y usaríamos la segunda.
Resultado 1: el código no tuvo defectos
Las doce implementaciones generadas no tuvieron ninguna discrepancia con la referencia en 20,000 entradas aleatorias por módulo: 240,000 casos en total.
Antes de creerlo, comprobamos que el probador no estuviera ciego: le metimos errores a propósito a una copia de la referencia y los detectó en todos los módulos probados, con cientos de discrepancias cada uno.
Así que la métrica principal se quedó sin material, como habíamos previsto que podía pasar. Es un dato en sí mismo: con especificaciones precisas y módulos pequeños, el modelo autor no dejó errores que las entradas aleatorias encontraran. Coincide con la explicación rival R3 del primer artículo: el código de IA puede tener una calidad base alta, al menos en tareas acotadas.
Resultado 2: las cuatro suites detectan casi todo
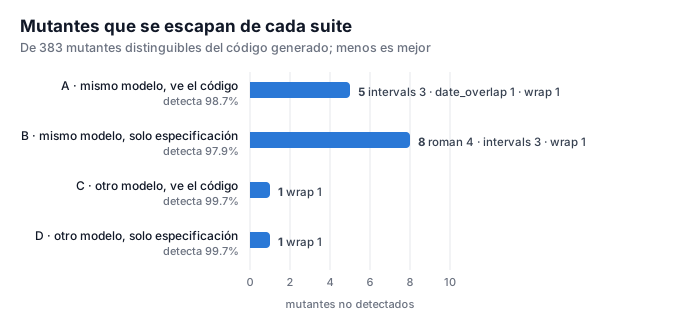
De 408 mutantes, 383 se distinguen de la referencia. Los demás son equivalentes o el probador no alcanza a diferenciarlos, y se excluyen.
| Celda | Pruebas | Mutantes detectados | Puntaje |
|---|---|---|---|
| A · mismo modelo, ve el código | 178 | 378 de 383 | 98.7% |
| B · mismo modelo, solo especificación | 177 | 375 de 383 | 97.9% |
| C · otro modelo, ve el código | 208 | 382 de 383 | 99.7% |
| D · otro modelo, solo especificación | 202 | 382 de 383 | 99.7% |
- A frente a D, la comparación prerregistrada: A detecta menos en 2 módulos, más en ninguno, y empata en 10. La diferencia agregada es de 1 punto. La prueba de signo da p = 0.25. Por el criterio fijado, el experimento no apoya la hipótesis.
- Ver el código no cambió nada medible. A y B (mismo modelo) quedan a menos de un punto, y C y D (otro modelo) empatan.
- Ninguna prueba afirmó algo falso. Las 765 pruebas de las cuatro suites pasan contra la referencia. No hubo ningún error «congelado», aunque hay que decir que tampoco había errores que congelar.
Resultado 3, exploratorio: el punto ciego del mismo modelo
Este análisis no estaba prerregistrado, así que lo presentamos como exploratorio.
Las suites A y B, las dos escritas por el mismo modelo que escribió el código, dejan pasar exactamente los mismos tres mutantes en el módulo de fusión de intervalos, una vea el código y la otra no. Los tres hacen lo mismo: al fusionar, comparan contra el primer intervalo del resultado en lugar del último. El error solo aparece si hay al menos dos intervalos separados antes de uno que se fusiona con el último, y ninguna de las dos suites probó ese caso. Las suites del otro modelo sí lo probaron y atraparon los tres.
Es la forma de causa común que plantea la hipótesis, pero en pequeño: el mismo modelo, con o sin el código delante, omitió el mismo caso. En total, las suites del mismo modelo dejaron pasar 13 mutantes y las del otro modelo, 2.
Antes de darle peso hay una explicación rival que no podemos descartar: el otro modelo escribió más pruebas (410 contra 355). Puede que no sea independencia, sino minuciosidad.
Dos hallazgos más, sueltos:
- La ida y vuelta puede no probar nada. La suite B, la única sin comparaciones contra valores
escritos a mano en números romanos, dejó pasar cuatro cambios en la tabla de valores (por ejemplo,
que
Dvalga 501). Usaba la propiedad que sugería la especificación: convertir a romano y de regreso debe dar el mismo número. Pero el código generado construye una conversión a partir de la otra, así que si la tabla está mal, las dos direcciones se equivocan igual y la propiedad sigue pasando. - Un caso que nadie probó. Un solo mutante sobrevivió a las cuatro suites: aceptar un ancho de línea 0 cuando el texto está vacío.
Un error en nuestra propia verificación
La primera versión de este análisis tenía un error, y lo encontramos al revisar un resultado que no
cuadraba. El ejecutor que corría las suites no registraba los fallos dentro de subTest, que varias
suites usan para agrupar casos: una prueba con un subcaso fallido desaparecía del resultado en lugar
de contar como fallida. Con ese error, los puntajes salían entre 90.9% y 96.3%, y once mutantes
parecían sobrevivir a las cuatro suites.
Lo descubrimos porque las cuatro suites probaban de forma explícita que to_roman(4000) debía
fallar, y aun así el mutante que aceptaba 4000 salía vivo. Corregimos el ejecutor, comprobamos el
caso y repetimos todo el análisis. Los números de este artículo son los corregidos, y el material
publicado incluye la corrección.
Lo contamos porque es el fenómeno de este artículo en primera persona: una verificación que pasaba en verde sin estar verificando. Lo detectó una comprobación de sentido común, no el propio verificador.
Qué está medido y qué no
| Afirmación | Estado |
|---|---|
| En módulos pequeños y bien especificados, el modelo autor no dejó defectos detectables con 240,000 entradas | Medido |
| La suite del mismo modelo que ve el código detecta claramente menos errores sembrados | No se sostiene con el criterio prerregistrado |
| Ver el código empeora las pruebas | No se observó |
| Las suites del mismo modelo comparten omisiones | Observado en un módulo, exploratorio; podría deberse a que escribieron menos pruebas |
| Una propiedad de ida y vuelta puede ser tautológica según cómo esté escrito el código | Mostrado con un caso concreto |
| La causa común no existe con IA | No demostrado: no había defectos reales que la pusieran a prueba |
Por qué podría diferir de otros estudios
Leu et al. (ESEM, 2026) encontraron que las pruebas de otro modelo no detectan más que las del mismo, y que cerca de 40% de los defectos solo los atraparon pruebas humanas. Este experimento no lo contradice, porque mide algo distinto en condiciones distintas:
- No había defectos reales. La causa común se manifiesta sobre todo cuando el código se equivoca, y aquí el código no se equivocó.
- Módulos pequeños y especificaciones precisas. Con la especificación delante, hay menos espacio para que el sesgo del modelo decida qué es correcto.
- Los dos modelos son de la misma familia. La independencia entre proveedores distintos es mayor que la que medimos.
- Una sola corrida por celda. No sabemos cuánto varía una suite si el mismo modelo la vuelve a escribir.
- Las celdas A y C pudieron ejecutar sus pruebas contra el código. Es parte de lo que significa ver el código en la práctica, pero no lo separamos.
Qué significa para la práctica
- Que las pruebas pasen no dice cuánto valen. Las 765 pruebas pasaban, y aun así entre 1 y 8 errores sembrados se le escapaban a cada suite. Las pruebas de mutación lo hacen visible, y son baratas.
- Un verificador distinto sigue siendo un seguro barato. En el único módulo donde hubo diferencia, el otro modelo atrapó lo que el mismo modelo omitió dos veces. El efecto es pequeño, pero va en la dirección de la recomendación del primer artículo.
- Cuidado con las propiedades que el código hace verdaderas por construcción. Una ida y vuelta solo prueba algo si las dos direcciones se calculan por separado. Hay que acompañarla con valores escritos a mano desde la especificación.
- Verifica también al verificador. Nuestro propio ejecutor reportó en verde lo que no había revisado. Sembrar un error conocido y comprobar que se detecta es la forma más barata de saber si una verificación funciona.
Cómo lo repetiríamos a mayor escala
- Tareas con defectos reales: módulos más grandes, especificaciones más ambiguas o problemas tomados de repositorios reales.
- Varias corridas por celda, para medir la variabilidad.
- Modelos de proveedores distintos y suites escritas por personas, como quinta celda.
- Igualar el número de pruebas entre celdas, para separar independencia de minuciosidad.
- Separar «ver el código» de «poder ejecutar las pruebas contra él».
Lo que este artículo no afirma
- No afirma que la causa común no exista. Afirma que, en este entorno y con el criterio que fijamos, no la observamos con fuerza, y que el entorno no tenía defectos reales con los que ponerla a prueba.
- No afirma que las pruebas generadas por IA basten. Todas dejaron pasar errores.
- No afirma que el modelo autor no se equivoque. Doce módulos pequeños no representan un sistema real.
- No cambia la recomendación del primer artículo de escribir pruebas antes del código y sumar un verificador independiente.
Material y fuentes
- Material completo del experimento: experimento-causa-comun.zip. Incluye las especificaciones, la referencia, el código generado, las cuatro suites, las herramientas (solo biblioteca estándar de Python) y los datos crudos. Con tres comandos se reproduce de punta a punta.
- Diseño y ejecución: Claude Code (Opus) con subagentes Opus y Sonnet, octubre de 2026. Quien diseñó el experimento también es una IA; por eso publicamos todo el material.
- Knight y Leveson, An experimental evaluation of the assumption of independence in multiversion programming, IEEE Transactions on Software Engineering 12(1) (1986).
- Leu et al., ESEM (2026).
- Dixi-Project: Deuda de verificación, Acotar, especificar y auditar y Enseñar ingeniería de software cuando la IA programa (2026).